Introducción: Cómo traducir de UML a PHP5 (I)

Estoy viendo muy seguido en foros que frecuento regularmente a muchos programadores que quieren dar "el gran salto" y evolucionar desde la programación estructurada hacia la programación orientada a objetos. El error más común que percibo es la falta completa de conceptos base, seguida de una pobre lectura de ejemplos sintácticos que no ayudan a comprender cómo verdaderamente se usan los objetos y cómo hacer para interactuar con ellos.

Estoy fervientemente convencido que enseñar conceptos de POO sin ayuda de UML es elegir el camino más empinado para el novicio. Cuando de abstracciones se trata, el cerebro trabaja mejor jugando con "imágenes", creando simples representaciones de lo que llamamos objetos y sus relaciones (tema que trataremos en otro artículo).

Bueno, no perdamos más tiempo y solucionemos esta carencia en 6 pasos concretos ;-)


Introducción: Representación de una clase

Una clase se representa con un "rectángulo" dividido en 3 zonas horizontales:
  • La primer zona se utiliza para colocar el nombre de la clase. Por convención los nombres de las clases inician con la primera letra en mayúsculas, y todas en singular (Persona, Cliente, Vendedor, Perro, Fruta, etc)
  • La segunda zona se utiliza para colocar la lista de atributos. Cada atributo iniciará con un símbolo que representará la "visibilidad" del mismo, que podrá ser "público" (+), "privado" (-) o "reservado" (#).
  • La tercer zona se utiliza para colocar los métodos de la clase. Cada método, igual que sucede con los atributos, deberá tener los mismos símbolos de "visibilidad" que se aplican con los atributos.
Se dice que la "zona de atributos" representa el estado actual del objeto (que cambiará según los valores que pueda tener en un momento dado) y la "zona de métodos" el comportamiento del mismo (dice qué puede hacer, qué se puede cambiar del mismo, qué se le puede preguntar, etc), configurando una suerte de "interfaz" que permitirá que otros objetos puedan interactuar con él (los objetos interactúan con otros objetos a través de sus métodos).

En este ejemplo podemos observar además que para cada atributo o método deberemos definir cual será el tipo de valor que manejará (String, Date, Integer, etc), no importando verdaderamente si nuestro lenguaje lo soporta en un 100%.

No hay que olvidar que UML es un lenguaje de modelado que permite comprender los diseños sin tener que llegar a conocer el código, y la traducción no está atada a ningún lenguaje de programación. Si el lenguaje es OO, se puede traducir, y tal vez, algunos detalles menores queden por el camino, pero que no debería afectar al concepto general de lo que se quiere transmitir.

Por ejemplo, PHP es un lenguaje de "tipado dinámico" (o lo opuesto a decir "tipado fuerte") donde según la asignación de valores (o su contexto de uso) define el tipo de la variable. Para el caso de la traducción del UML, cada vez que veamos el "tipo", este dato nos servirá como documentación sobre qué información manejaremos internamente, pero no se traducirá en código explícito (porque el lenguaje no lo provee).

Nota: por eso muchos critican a PHP en general. Al no tener un "tipado fuerte" no lo consideran un lenguaje orientado a objetos "robusto" (al existir menos controles sobre los valores que manejan las variables). Según el autor de PHP, esto es una ventaja del lenguaje -la flexibilidad- y juega en favor de los programadores, no en contra.

Paso 1) "Nombre del archivo"

Normalmente usamos un nombre seguido de la extensión: prueba.php. En el caso de los objetos, hay muchas opiniones al respecto. La mayoría de los autores sugiere diferenciar un archivo que define una clase de un archivo que usa varias clases predefinidas.

He visto autores que usan la siguiente nomenclatura: class.NombreDeLaClase.php.

En mi caso, yo siempre me sentí más cómodo usando NombreDeLaClase.class.php y así sigo manteniendo la estrategia de no alejarme mucho de Java para contar con un modelo de referencia para poder aprender de él.

La única ventaja que encuentro en la primera opción es que si listamos todos los archivos de un directorio, todos los que empiecen con "class." estarán juntos.

Para seguir el ejemplo, mi ejemplo, usaremos: Persona.class.php

Paso 2) "Definir la clase"

Aquí debemos ceñirnos a la sintaxis del lenguaje de turno al cual queremos convertir desde un diagrama UML. En nuestro caso, es PHP5, por lo cual solo debemos ir hasta el manual, buscar la parte donde hablan de creación de clases y hacer la siguiente conversión mecánica.
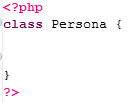
Nota: si usamos Eclipse como IDE para desarrollar, al momento de decirle "crear nuevo archivo php" y colocarle de nombre ".class.php", nos arma un esqueleto más completo de forma totalmente automática ;-)

Paso 3) "Definir los atributos"

Si ya tenemos el esqueleto principal, solo debemos leer uno a uno los atributos del UML y pasarlos a código casi de forma directa:
Como comentaba, no tenemos que preocuparnos de no disponer de un "tipado fuerte" (como sucede con Java) que nos obligue a escribir en la definición de atributos de que tipo son.
Podemos aplicar algunas "sutilezas" pero que en realidad no aportan mucho valor:

private $nombre="";

Con esta asignación estamos diciendo que el atributo es de tipo String.

En este caso, y para PHP, el tipado en el UML nos aporta información extra para la documentación de nuestro sistema (por lo cual no hay que obviarla a la hora de diseñar, aunque nuestro lenguaje no lo soporte explícitamente).

Paso 4) "Definir los métodos"

Siguiendo el mismo razonamiento que el usado en el caso anterior con los atributos, los métodos deben definir también su visibilidad:

Paso 5) "Definir un constructor"

Generalmente, aunque esto es flexible, en un diagrama UML que representa una clase no hace falta agregar como método el propio constructor de la clase; en sí, se sobreentiende que constará de uno y no aportaría nada nuevo a la documentación del diseño (de la misma forma que sucedería con los métodos "getter" y "setter", que hablaremos en otro artículo).

Como los atributos son "privados" (no se tiene acceso a los mismos desde fuera de la clase) para poder asignarles valores iniciales en el momento justo de la creación, deberemos crear un método constructor:

Recibimos los 3 parámetros desde el constructor y luego los asignamos a los atributos de la clase.

Este método se ejecuta "automáticamente" cuando hacemos un "new" para crear una instancia a partir de la clase (que se ve en el próximo paso).

Paso 6) "Probarlo"

Creamos la clase, usando el constructor, para luego usar un método del objeto.
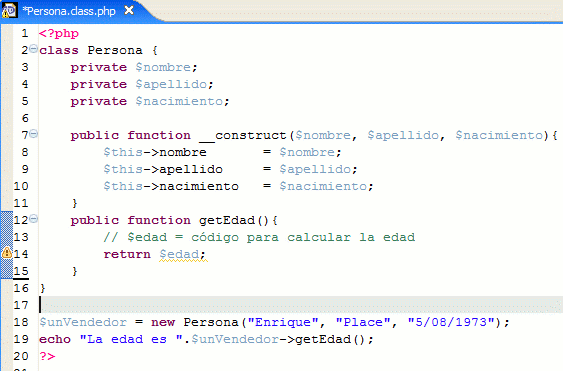

Este ejemplo, en realidad, no imprimirá la edad del "vendedor", puesto que para simplificar el ejemplo y no agregar "ruido" al código (¡si habré visto libros con códigos innecesariamente complejos!), no está implementada la fórmula para calcular la edad a partir de la fecha de nacimiento ingresada (pero creo que la idea general se entiende).


Resumen final

Fuimos viendo paso a paso como se traduce a PHP5 la representación en UML de una clase definida en el contexto de la programación orientada a objetos. Conocimos las 3 zonas que definen una clase (nombre, atributos y métodos), la visibilidad (métodos y atributos), el constructor (para definir un comportamiento al crear el objeto) y finalmente, como probar la clase creada.

¿Dudas o sugerencias? Bienvenidas en los comentarios de este artículo ;-)

Artículo basado en una respuesta que di en Foros del Web

Actualización (27/07/2006): las capturas de pantallas están hechas sobre las siguientes herramientas: la versión "comunitaria" (gratuita) de Poseidon (basado en el proyecto libre ArgoUML) y Eclipse (usando el paquete EasyEclipse for PHP).

Conceptos: "Separar el código de la capa de presentación"

Muchas veces me han hecho esta pregunta, y muchas veces la he leído en foros de discusión, lo cual escribir repetidamente la respuesta se me hace un poco cansador.

En los próximos artículos voy a ir documentando estos casos, así cuando me lo vuelvan a preguntar, los remito aquí ;-)

En la programación por capas siempre debemos separar nuestro sistema en más de una "capa", donde por un lado tendremos una capa con la responsabilidad de implementar la "lógica" de nuestro sistema, y separar en otras capas las demás responsabilidades: capa de persistencia, de presentación (también llamada "interfaz" o "gui"), etc.

Capa de Lógica

A la capa de lógica también se le puede conocer con distintos nombres ("lógica de negocios", "dominio del problema", etc) y no necesariamente es una, puede estar compuesta por varias con distintos niveles de complejidad dentro (es decir, una capa que internamente tiene varias capas). Aquí es donde verdaderamente resolvemos el problema concreto, separado de los demás detalles que conforman nuestro sistema (que serían las otras capas, o las otras responsabilidades).

"Bajo Acoplamiento" versus "Reacción en Cadena"

Conceptualmente, lo único que debemos hacer es tener "separada" las responsabilidades en fuentes distintos, o en conjuntos de fuentes distintos (dependiendo el tamaño de nuestro sistema). Es decir, un conjunto de fuentes solo trabajarán la parte de la "lógica" donde tendrán prohibido hacer algo de la "presentación", y viceversa. Cada uno tendrá un punto de contacto que podrán ser datos pasados por parámetros, un objeto parámetro, una capa de "fachada", etc.

Aplicar cualquier estrategia que nos evite que nuestros subsistemas (o capas) estén "altamente acoplados", evitando que cada uno conozca detalles internos del otro para que cuando uno cambie no sea afectado en cadena la integridad de nuestro sistema, situación que nos obligará a modificar muchos fuentes para solucionarlo.

Un ejemplo práctico

En la capa de lógica tengo los fuentes que crean un resumen de cuenta de un cliente; arma la información necesaria a partir de los datos que fueron solicitados oportunamente a la capa de persistencia, para luego de terminada la tarea, cederle la responsabilidad a la capa de presentación para que -a partir de los datos ya procesados- armar una pantalla con columnas y colores, ubicando los datos donde corresponden.

La lógica no debe desplegar nada en pantalla ni tener acceso directo a la base de datos.

Su punto de contacto con los datos debe ser una clase que representará a la capa correspondiente a la cual le pedimos los datos con la mínima cantidad de información posible. No tendría sentido tener nuestro sistema separado en capas y que la lógica envíe sentencias SQL, lo que significaría que nuestra capa conoce demasiados detalles internos de otra capa, rompiendo el encapsulamiento. De la misma forma, tendríamos otra clase que representará a la "capa de presentación" que se encargará de recibir los datos y que nuestra "lógica" se desentenderá posteriormente (ya no será su responsabilidad).

¿PHP lo soporta?

Se puede hacer perfectamente con PHP, pero el tema es más simple de lo que parece: no debemos tener todo entreverado en los mismos fuentes, debemos ser ordenados y metódicos, separar cada objeto según su responsabilidad, y colocarlos en "contenedores" distintos.

Una forma de hacerlo es a través de herramientas, como Smarty, que permite trabajar separadamente tu código (la lógica) del código html (la presentación), donde dispondremos de un lenguaje propio para resolver problemas de la interfaz, facilitando la separación de capas.

Otra forma de hacer es con las propias "herramientas" que nos debería proveer el lenguaje (como sucede con Java o .Net), que nos facilitaría enormemente la administración y uso de las capas, tema tratado oportunamente en otro artículo en este blog.

Artículo basado en una respuesta que di en Foros del Web

"Hoja de referencia rápida para el Smarty template engine"

"Smarty es uno de los templates engine (y tal vez un poco más allá) más populares entre los programadores que usan PHP. En somewhere in … colourful moments , publicaron un cheat sheet (hoja de referencia rápida) orientada a diseñadores de plantillas, que pueden encontrar bastante útil: Smarty cheat sheet for template designers."

Más información:

"15 tutoriales de PHP para principiantes"

En SentidoWeb comentan que la empresa Zend (los creadores de PHP) han escrito 15 tutoriales dentinados a principiantes, para lograr crear una buena base de conocimientos. En lo personal, los voy a leer uno por uno (siempre te llevas la sorpresa al encontrar algo que no sabías, o por lo menos, no recordabas).

SentidoWeb se tomó el trabajo de armar una lista más descriptiva con comentarios de cada uno de los tutoriales:
  • Fundamentos de PHP: crear un 'Hola Mundo', comentarios, variables, tipos, ... Lo más básico y necesario de PHP.
  • Parámetros de entrada y condicionales : cómo se reciben los datos que nos llegan desde la URL y el uso de comparaciones e instrucciones condicionales.
  • Bucles y más condiciones: Bucles (for, while, ...) y cómo comprobar si una variable está definida.
  • Arrays: tratamiento de arrays, incluyendo el foreach.
  • Ficheros: abrir, leer, escribir en ficheros.
  • Funciones: uso de funciones, sus parámetros de entrada y variables globales.
  • Clases : todo lo necesario para la programación orientada a objetos mediante PHP.
  • MYSQL : acceso a base de datos MYSQL, imprescindible si quieres realizar alguna aplicación web.
  • SQLite: otra base de datos.
  • Sesiones: tratamiento de sesiones y coockies.
  • XML: tratamiento de XML, solo para PHP5, en PHP4 también se pueden tratar.
  • Tratamiento de errores : si vas a realizar una aplicación, gasta bastante tiempo en el tratamiento de errores, algo para mí fundamental.
  • Principios de seguridad: validación de los campos de entrada, sobre todo para cuestiones de BD.
  • Nuestra primera aplicación web: una vez conocido todo lo anterior, ya estamos preparados para hacer nuestra primera aplicación web.
  • Agregador RSS: creación de un pequeño agregador RSS.
Ya tengo la respuesta rápida para la próxima vez que me pregunten "que debo leer para empezar a programar en PHP" ;-)

Enlace original: PHP Tutorials for Absolute Beginners

Comentarios sobre: "¿Cual es la mejor capa de abstracción?"

Escribí una respuesta a un comentario de un lector del blog y esta se me volvió casi un "post" completo. Para que no quede en el olvido, lo muevo aquí, pues es algo que me han preguntado mucho y que he sugerido mucho sin que me preguntaran ;-)

Todo se inició hablando de componentes de Pear que ofrecen los servicios de "abstracción de Bases de datos", que entre otras cosas nos evitan que usemos  funciones específicas de PHP que nos atan a la base de datos de turno.

Marconi me consulta si no es mejor MDB2, lo cual le respondo lo siguiente:

Lo de "mejor o no", es dependiente siempre del contexto ;-)

No he tenido el gusto de probar todas las alternativas existentes en Pear, como el caso de MDB2, pero si te puedo hacer una sugerencia:

Crea un "capa de abstracción" que te "abstraiga" de las herramientas que ofrecen los servicios de "abstracción de bases de datos concretos" ;-)

Es decir, crea una clase BaseDeDatos (o como quieras que se llame) que use internamente, por ejemplo, MDB2. Deberás implementar por lo menos las operaciones básicas (conectar, desconectar, consultar, registros afectados, etc) ... pero no lo haces de cero, internamente lo haces con MDB2.

Si en un futuro, cercano o lejano, encuentras otra herramienta de abstracción que se adapta maś a tu contexto (rendimiento, flexibilidad, simplicidad, etc), podrás reemplazar MDB2 por la nueva, sin que tu aplicación se vea afectada por el cambio (ella dependerá de tu clase "BaseDeDatos", y no concretamente de una herramienta específica).

Una premisa en Diseño Orientado a Objetos es: "no dependas de implementaciones concretas, solo de implementaciones abstractas".

Veo muy seguido que los "novatos" (los que hacen sus primeras armas) lo primero que intentan es crearse componentes "de cero" (como la capa de abstracción) sin usar herramientas que los auxilien.

Reutiliza, no reinventes la rueda constantemente.

Pierde tiempo en las cosas que interesan, las que aportan "valor agregado" a tus desarrollos y a tus clientes.

Testeando la velocidad de las sentencias de PHP5 y PHP4

"Interesante estudio sobre comparativa de sentencias en PHP5 que obtienen el mismo resultado, para conocer cual de ellas es la más rápida. Por ejemplo: es más rápido concatenar una cadena a una variable usando el punto (.) que incluyéndo la variable entre comillas dobles, para expresiones regulares es más rápido usar preg_match que eregi, es 8 veces más rápido usar explode que split. También es una buena referencia para saber como hacer lo mismo de distintas formas. Pero lo que más me ha sorprendido es que comparando con PHP4 las expresiones regulares se han vuelto más lentas (casi 7 veces más rápido en PHP4 que en PHP5), lo cual me hace pensar que o bien es debido a una mejora que completa las expresiones regulares, o antes no se hacían muy bien, porque ir a peor no tiene mucho sentido."


Artículo completo en: SentidoWeb

¡Ahora, todo en un mismo dominio: PHP Cinco + Pear + Smarty = PHP Senior!

En un principio creé este blog, PHP Cinco, a mediados de agosto de 2005 para hablar de la nueva versión de PHP, concretamente la "5". El cambio de versión propiciaba toda una "revolución", pero no todos los programadores fueron conscientes de las nuevas puertas que se nos abrieron para potenciar nuestros desarrollos. De golpe, dimos un salto que nos permite acercarmos a niveles de programación similares al que se consigue con el famoso lenguaje Java. Este fue un primer importante paso que permitirá a PHP dejar de ser solo un lenguaje a convertirse en una plataforma de desarrollo.

En este caso tuve poca visión, o por lo menos, una visión muy a corto plazo. No se me ocurrió mejor idea que registrar el blog como phpcinco.blogspot.com y así lo llamé por unas semanas. Con el tiempo, creé varios otros blogs sobre temas que si bien se tratan en entornos PHP (como Pear y Smarty), seguí con la idea de que cada blog tuviera una temática muy concreta y especializada. El tiempo y la experiencia sirvió para decantar y pulir la estrategia: voy a unir los blogs sobre Smarty, Pear y PHP, en un nuevo nombre más genérico (que hace un tiempo ya estaba usando como "nombre fantasía" del blog): PHP Senior

En los blogs originales voy a hacer referencia en un último "post" que ahora nos encontramos en "PHP Senior" y voy a terminar de migrar los contenidos.

Si tenemos que hablar de Smarty o Pear, o de PHP5 (o el futuro PHP6), o del nuevo framework o el futuro RAD, lo haremos todo desde "PHP Senior".

¡Los espero, no se pierdan! ;-)

Pear: "PHAR - los .jar en PHP"

"Dentro de las librerías PEAR se está desarrollando una nueva forma de distribuir aplicaciones desarrolladas en PHP.
De la misma forma que java permite distribuir las aplicaciones en un solo archivo .jar, ahora en php podremos hacerlo con .PHAR"

Algunos links:

Fuente:

"Petición para soporte de Name Spaces en PHP5"

Este tema lo comenté por primera vez cuando escribí sobre cómo se representaría una arquitectura de 3 capas en PHP5. Ahora me entero que era más grave de lo que yo pensaba ;-)

Noticia extraida de VivaPHP:
"Petición para soporte de Name Spaces en PHP5 (07.04.2006)

PHP¿Hasta dónde pueden llegar los programadores de PHP en su súplica para que los desarrolladores de Zend vean la luz y agreguen de una soporte de name spaces a este lenguaje? Pues hasta el punto de organizar una petición on-line para implorar que por lo menos incluyan el parche de Jessie Hernandez en la próxima versión de PHP5.

El soporte de name spaces está en seria consideración para PHP6, con una álgida discusión en la lista de correo de php-internals sobre la mejor forma de implementar esta retrasadísima característica."

Antes que saliera la versión final de PHP5 leí la documentación sobre lo nuevo que incorporaba y se hacía referencia constante al concepto de "namespace". Al principio me sorprendió porque PHP5 se basa mucho en la sintaxis que usa Java para implementar los objetos y este usa la sintaxis "package" y solo en .Net se usaba "namespace".

La mayor sorpresa fue que cuando se liberó la versión final de PHP5, este no soportaba los "namespaces" (a pesar de haberlos probado en la beta).

Volviendo al tema, para ubicarnos un poco en el contexto, este tipo de sintaxis nos permite representar el concepto de diseño llamado "arquitectura en capas" o directamente "programación en tres capas" (pueden haber muchas más capas, pero generalmente se habla de que deberían existir por lo menos tres), donde deberíamos separar claramente las distintas responsabilidades básicas de nuestros sistemas.

La primer capa, la presentación, sería la encargada de manejar nuestra "interfaz" con los usuarios (pantallas gráficas, páginas web, etc), la segunda capa, el dominio o lógica, donde deberemos alojar el código que resuelve concretamente la problemática de nuestro sistema, y por último la tercer capa, la persistencia, que tendrá la responsabilidad de "persistir" la información, tanto almacenarla en una base de datos o en un archivo de texto (o en cualquier otro medio), para luego poder recuperarla cuando lo requiera nuestro sistema.

La idea de la "arquitectura orientada a capas" es que tenemos separadas de forma clara las responsabilidades, desacoplando nuestro código.

Si no tuviéramos capas, que es lo mismo que decir que tenemos una sola capa, nuestro código tendría entreveradas todas las responsabilidades. Cualquier cambio que se quiera hacer al código que implementa la interfaz afectaría a todo el resto del código. Si necesitáramos cambiar de interfaz (pasar de un sistema de escritorio de ventanas a un sistema web) deberíamos modificar todas las llamadas en nuestro código que cumplen esa tarea. Pero si tenemos "capas", podemos crear un nuevo "paquete" y sustituirlo por el anterior, y nuestro sistema debería poder seguir funcionando sin problemas. Sería exactamente el mismo caso si tuviéramos que cambiar de motor de bases de datos, solo deberíamos poder cambiar de "capa" y nuestro sistema seguir operativo (o por lo menos, las modificaciones solo afectarían un paquete, no al resto).

En UML cada capa representa un "paquete" (o viceversa), y estos contienen en su interior clases u otros paquetes, y en muchos lenguajes (como Java) esto se traduce físicamente en un directorio.

La idea es que si nuestro Gerente nos entrega el diagrama UML, nosotros deberíamos poder interpretar el diagrama y representarlo en código en alguno de los lenguajes disponibles que cumplan con la Orientación a Objetos.

La desventaja que tiene PHP, al no soportar los namespace, es que no podemos cumplir fielmente los diagramas UML al tener que incluir individualmente los archivos que vamos necesitando, cuando deberíamos poder hacer referencia directa a un "paquete" como una "unidad".

No es lo mismo decir en nuestro código:

namespace dominio;
namespace persistencia;

Que tener que hacer referencia a cada uno de los archivos que vamos a utilizar de nuestro "paquete":

require_once 'persistencia/BaseDeDatos.class.php';
require_once 'dominio/Clientes.class.php';
require_once 'dominio/Acreedores.class.php';
require_once 'dominio/Factura.class.php';
require_once 'dominio/LineaFactura.class.php';


Lo más grave de todo es que nos debilita el diseño al no permitirnos cumplir con lo básico de los "principios del diseño orientado a objetos". Nosotros deberíamos reusar "paquetes" y no partes concretas de esos paquetes (en este caso, serían las clases).

Esperemos que se implemente en PHP6 y demos un nuevo gran paso.

Programación: "Orientada a la Implementación" versus "Orientada a la Interface" - Parte 1 (revisado 11/12/2008)

Gran dilema les voy a plantear. Acompáñenme al esotérico mundo del Diseño Orientado a Objetos ;-)

Supongamos que tenemos un sistema que hará las funciones de "máquina de escribir", donde obtendrá información a través de un dispositivo de entrada y luego enviará esta información a un dispositivo de salida.

Nuestro diseño estará compuesto por dos paquetes (en el contexto UML) que nos ofrecen los siguientes servicios:

Lógica: donde tendremos la implementación de "alto nivel" de nuestro problema (donde se manipularán los dispositivos).

Dispositivos: donde la implementación de nuestro paquete de "lógica" tendrá acceso a servicios de "bajo nivel" provisto por este paquete.


Entrando en el diseño interno de los paquetes, tendremos:

- Dentro del paquete "Dispositivos": las clases "Teclado", que retornará información en formato de texto, e "Impresora", que en algún momento recibirá un texto para ser impreso.

- Dentro del paquete "Lógica": la clase "MaquinaDeEscribir", que se encargará de crear las instancias correspondientes a los dispositivos de entrada/salida, y pasar la información que devuelve una clase a otra clase.

Imprementación

Seguiremos textualmente los diagramas UML para hacer la codificación de nuestras clases. Empezaremos con los dispositivos.

Archivo: Teclado.php

class Teclado
{
public function leer()
{
// a efectos del ejemplo, solo retornará un
// un texto como representación de una
// entrada de datos
return "texto ingresado";
}
}


Archivo: Impresora.php

class Impresora
{
function escribir($texto)
{
echo $texto;
}
}


Archivo: MaquinaDeEscribir.php


require_once 'dispositivos/Teclado.php';
require_once 'dispositivos/Impresora.php';

abstract class MaquinaDeEscribir
{
static function run()
{
$miTeclado = new Teclado();
$miImpresora = new Impresora();

$miImpresora->escribir($miTeclado->leer());
}
}

¿Cómo se prueba?

Una posible solución creativa, tratando de llevar a PHP hacia un lenguaje 100% Orientado a Objetos (como Java), donde *todo* debería ser un objeto, se usará el "index.php" como una clase "Index".

Nota1: siguiendo el comportamiento estándar de los servidores web, cuando nos posicionemos en la url de nuestro sitio el servidor buscará todos los documentos que inicien con el nombre "index" (minúsculas) y luego probará varias extensiones hasta dar con el archivo inicial (.html, .htm, .php, etc). Hay autores que usan "class.NombreClase.php" o NombreClase.class.php, nosotros usaremos el estádar definido por Zend (NombreClase.php) y para este caso particular simplemente "index.php".

Resumiendo: Solo en este caso, para mantener el estándar web, nuestro archivo se llamará "index.php" y la clase internamente será "Index" (la primer letra en mayúsculas y la palabra en singular).

Nota2: cuando en un diagrama UML tenemos una flecha que apunta hacia otra clase (cualquier flecha), en PHP se traduce *siempre* (o por lo menos hasta la fecha de hoy) en incluir ese fuente con la sentencia include, require, etc. En el caso siguiente, y basado en nuestro diagrama UML, nuestra clase "Index" requerirá *solo* de la clase "MaquinaDeEscribir".

Nota3: como no hace falta instanciar la clase para invocar un método, creo una clase "abstracta" y ejecuto directamente la clase e invoco su método, evitando crear una instancia (menos código, no reservo memoria para la instancia, etc).


require_once "logica/MaquinaDeEscribir.php";

abstract class Index
{
static public function run()
{
echo 'Ejecuto máquina de escribir->';
MaquinaDeEscribir::run();
}
}

Index::run();

Ok, nuestro ejemplo está funcionando.

Ahora la pregunta es: ¿existe alguna otra mejor forma de hacerlo?

Programación Orientada a la Interface

Por suerte sí, existe otra forma: usando interfaces. Para poder aplicar esta nueva forma de solucionar el problema, debemos "dar vuelta" la forma que usamos los objetos de nuestro ejemplo. En el caso anterior, la clase de "alto nivel" dependía de dos clases de "bajo nivel", lo que significa algo muy grave: "la clase de alto nivel es *dependiente* de los cambios que puedan sucederle a las clases de bajo nivel, es decir, nuestro alto nivel depende de los detalles de implementación del bajo nivel".

El problema de nuestro diseño es que estamos programando "orientado a la implementación".

¿El diseño anterior, puede considerarse un buen diseño?

  • ¿Cuan mantenible será nuestro sistema si elementos de bajo nivel pueden generar cambios en todo el modelo?
  • ¿Es correcto que nuestra MaquinaDeEscribir dependa de cómo se toman los datos y de cómo se imprimen?
  • ¿Qué es lo más importante en nuestro diseño? ¿la Lógica o los Dispositivos?
  • ¿Este diseño, es reutilizable? ¿podemos reutilizar el MaquinaDeEscribir en otros contextos?
  • ¿Su costo de mantenimiento es alto o bajo? ¿cuanto código hay que agregar para extender su comportamiento (para cubrir un nuevo requerimiento)?
  • ¿el código presentado se mantiene, o hay que adaptarlo cada vez que queramos extender su funcionamiento?

Todas estas preguntas serán desveladas en el próximo capítulo ;-)

Entradas populares